Пароль разблокировали. Почему сотрудник снова не может войти?
В понедельник Анна из бухгалтерии не смогла войти в рабочую систему: учётная запись заблокирована. Поддержка восстановила доступ. Через час с такой же жалобой обратился Олег из отдела продаж. Во вторник Анна написала снова.
Это три разных обращения. Специалисты помогают каждому сотруднику, но повторные разблокировки не отвечают на главный вопрос: что вызывает сбой и как остановить повторения?
В «Управлении IT-отделом 8» работу с общей причиной можно вести двумя способами: через документ «Проблема» или через отдельный проект. Разберём оба на одной истории.
У обращений разные авторы, у сбоя может быть одна причина
Каждая блокировка — отдельный инцидент: сотрудник не может работать, ему нужно вернуть доступ. Проблема — причина или потенциальная причина таких инцидентов. Её ещё предстоит установить: похожие симптомы сами по себе не доказывают, что причина общая.
Руководитель поддержки замечает повторения после смены паролей. Вместо очередного поручения «разблокировать Анну» он выделяет отдельную работу: выяснить источник блокировок. Обращения сотрудников продолжают обрабатывать, а расследование получает своего исполнителя.
Польза здесь вполне практическая. Если на каждую повторную разблокировку уходит 10 минут, шесть таких обращений — час работы поддержки. Это условный расчёт, а не замер: для оценки своего результата нужно учитывать реальные трудозатраты и число повторений.
Способ 1. Собрать связанные инциденты в документе «Проблема»
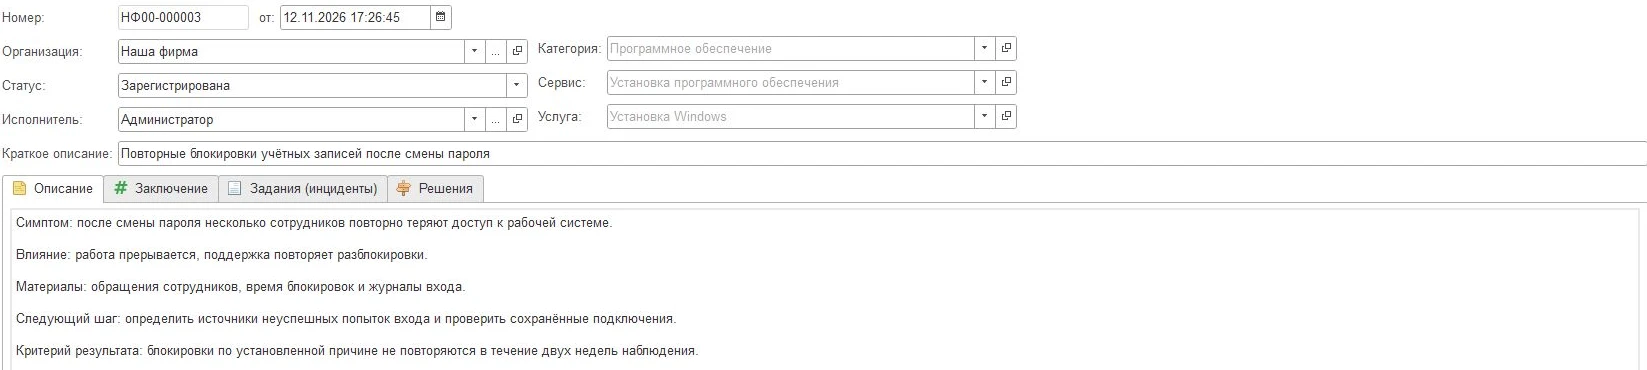
Создаём документ «Повторные блокировки учётных записей после смены пароля», описываем симптомы и назначаем исполнителя. На вкладке «Задания (инциденты)» собираем связанные обращения Анны, Олега и других сотрудников. Теперь специалист видит, какие случаи нужно сопоставить.
У документа есть статусы «Зарегистрирована», «Ошибка известна», «Решена» и «Отменена». По мере расследования в нём сохраняют выводы: в «Заключении» — найденную причину и результат, в «Решениях» — ссылки на подходящие статьи базы знаний.
В нашей истории исполнитель сравнивает время блокировок и журналы входа. Выясняется, что на устройствах сохранились подключения со старыми паролями: они продолжают попытки входа и блокируют записи. После проверки этой причины специалист обновляет настройки подключений и описывает решение.
Такой способ подходит, когда важно собрать несколько инцидентов вокруг одной проблемы и сохранить общее заключение. Результат по каждому обращению проверяют отдельно: восстановился ли доступ именно у этого сотрудника. Закрывать обращение только из-за похожих симптомов рано.
Способ 2. Вести расследования в отдельном проекте
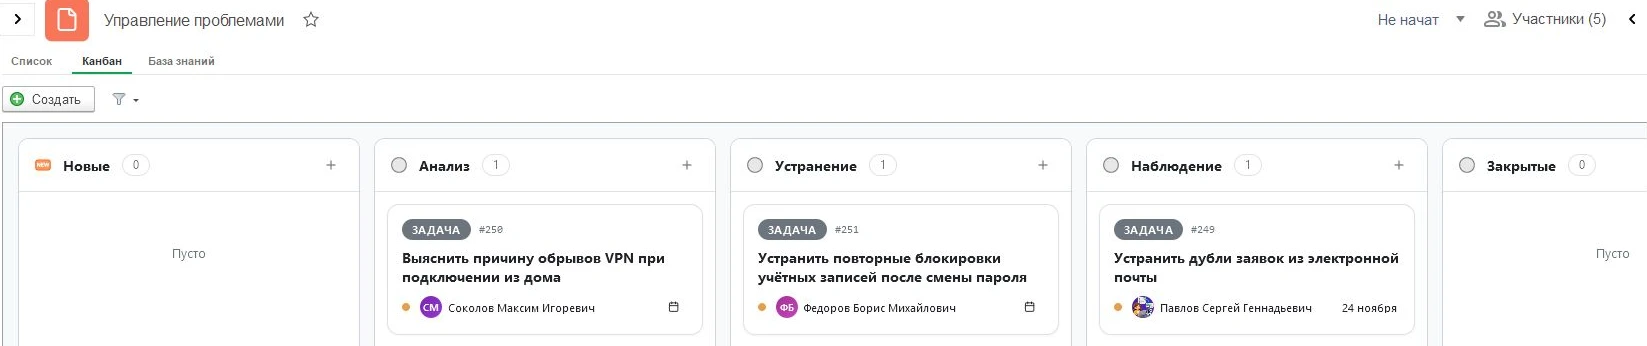
Если руководителю нужно регулярно разбирать несколько проблем вместе с командой, удобно создать проект «Управление проблемами». Каждую проблему оформляют заданием, а продвижение показывают на канбан-доске.
Для проекта подготовим пять разделов:
-
Новые — повторения замечены, материалы ещё нужно разобрать.
-
Анализ — исполнитель собирает данные и проверяет гипотезы.
-
Устранение — причина подтверждена, выполняется исправление.
-
Наблюдение — исправление внесено, проверяем его на обычной работе.
-
Закрытые — результат проверен и принят ответственным.
Настройка разделов и участников проекта описана в документации по проектам.
Работа со списком, панелью деталей и канбан-доской разобрана в статье «Интерфейс работы со списком заданий».
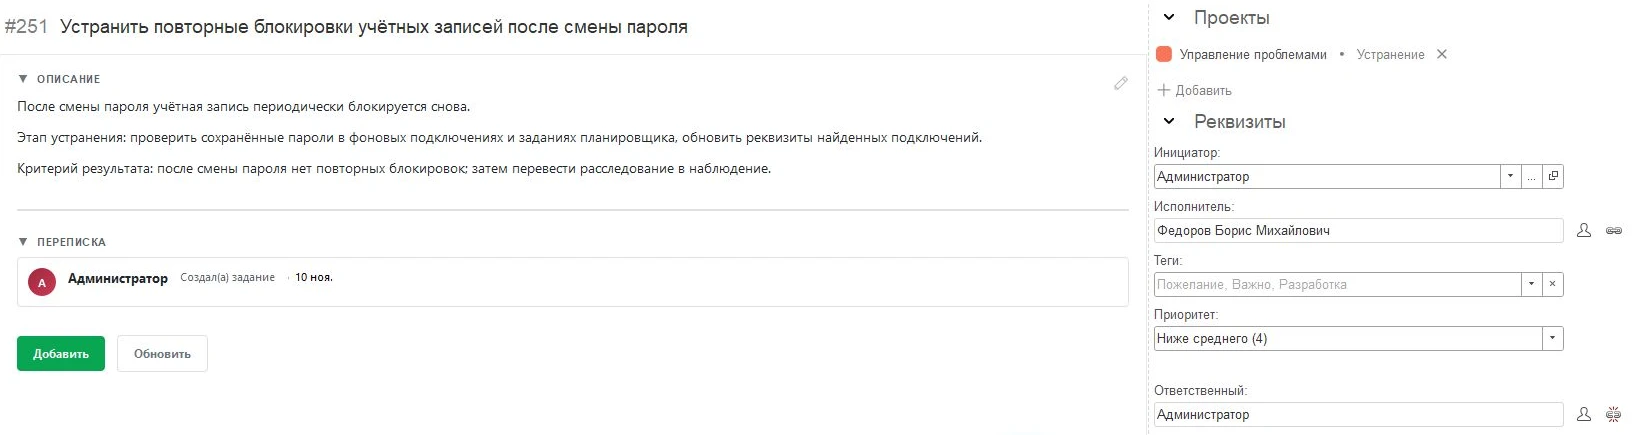
В задание «Устранить повторные блокировки учётных записей после смены пароля» заносим исходные сведения:
Симптом: после смены пароля несколько сотрудников повторно теряют доступ из-за блокировки записи.
Влияние: сотрудники прерывают работу, поддержка возвращается к разблокировкам.
Материалы: номера обращений, время блокировок, журналы входа и сведения об устройствах.
Следующий шаг: найти источники неуспешных попыток входа и проверить сохранённые подключения.
Критерий результата: доступ работает; блокировки по установленной причине не повторяются в период наблюдения.
Текущий исполнитель проводит расследование и исправляет настройки. Ответственный контролирует следующий шаг и проверяет результат. Например, системный администратор устраняет причину, а руководитель поддержки принимает работу. Поле «Ответственный» помогает разделить роли; порядок приёмки команда определяет заранее.
Обращения собираем под одной проблемой
К заданию о проблеме, используя функционал подзаданий, добавляем все поступающие задания от клиентов по этой проблеме. В нашем примере основное задание №251 посвящено поиску причины блокировок, а подзадания №252–254 — отдельным обращениям бухгалтерии и отдела продаж.
Обращения остаются в проекте «Поддержка сотрудников», со своими описаниями и перепиской. В основной задаче открываем «Дочерние задания» и переходим к нужному случаю: кто потерял доступ, когда повторилась блокировка и что уже проверили.
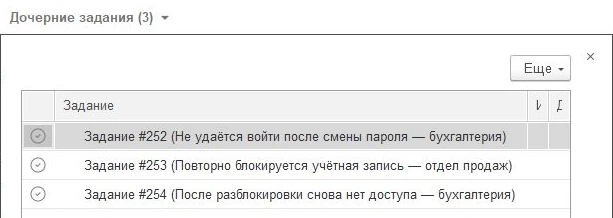
Как связать карточки через поле «Родитель» и открыть список подзаданий — в инструкции по работе с подзаданиями. После исправления проверяем результат по каждому обращению; сама связь не заменяет эту проверку.
Раз в неделю — короткий разбор доски
На встрече команда смотрит, где остановилась работа. По блокировкам исполнитель уже нашёл источник попыток входа и обновляет сохранённые пароли. По обрывам VPN ещё собирает журналы. Руководителю не нужно заново выяснять историю каждого обращения: в карточке есть материалы, исполнитель и ближайший шаг.
Порядок расследований выбирают по влиянию на работу и частоте повторений. Если одна проблема каждый день останавливает целый отдел, её стоит обсудить раньше редкого сбоя у одного сотрудника.
Исправили — оставляем две недели на наблюдение
Исполнитель обновил подключения со старыми паролями и проверил вход. Теперь карточка переходит в «Наблюдение». Задание остаётся открытым: одного успешного входа недостаточно, чтобы считать повторяющуюся проблему решённой.
В комментарии фиксируем, какие подключения исправлены и когда. Назначаем контрольную проверку через две недели. Этот срок выбирает команда: если сбой возникал реже, наблюдать нужно дольше.
В контрольную дату ответственный проверяет новые обращения и журналы блокировок. Важно, чтобы сотрудники за это время действительно работали в системе: отсутствие жалоб во время отпуска ничего не говорит об исправлении.
Основание для закрытия: источники попыток входа со старыми паролями устранены; сотрудники подтвердили доступ; за период наблюдения блокировки по этой причине не обнаружены. Даты, проверенные записи и исключения сохраняем в карточке.
Если блокировки повторились, возвращаем задание в «Анализ» с новыми данными. Если критерии выполнены, ответственный принимает результат, задание отмечают выполненным и переводят в «Закрытые». Автоматический перенос зависит от настроек проекта: название раздела и статус выполнения задания — разные состояния.
В конце месяца смотрим, что перестало повторяться
Отбираем выполненные за период задания проекта и читаем итоговые записи: какую причину нашли, что изменили и чем подтверждён результат. Отдельно смотрим проблемы в наблюдении и возвраты в анализ.
Например, блокировки учётных записей устранены и прошли контроль, а обрывы VPN ещё расследуют. В итог периода попадёт одна решённая проблема. Несколько связанных обращений не превращаются в несколько устранённых причин.
Чтобы оценить пользу, сравниваем число повторных инцидентов и время на их обработку до и после исправления при сопоставимой нагрузке. Само количество закрытых карточек не покажет, стало ли сотрудникам проще работать.
Начните с одного сбоя, с которым поддержка сталкивается снова и снова. Соберите обращения, назначьте исполнителя и ответственного, определите критерий результата. А после исправления оставьте время на наблюдение — тогда у закрытия будет проверяемое основание.